
 最新跨境运营干货
 看多维度榜单信息
虾皮类目选择画成分布图,看的是哪一层
先要问清楚,你要看的到底是哪一层。类目这件事至少有三种问法,一个类目在九个站点上分布得怎么样。同类目里不同的价位段各占多少。同一批候选在某一项特征上谁高谁低。三种问法对应三种不同的排法,画在同一张图上只会互相干扰。
问清楚层次这件事,听起来抽象,落到动作上其实很具体。你要在图上找的是某一个类目的位置,还是某一段价位的厚薄。找类目的位置,横轴上排的就应该是类目名。找价位的厚薄,横轴上排的应该是价位段。这两件事画在同一张图上,读的人会不知道该看哪一头。
层次还体现在纵轴上,同一个横轴可以配两种纵轴。一种放的是数量,一种放的是占比。放数量,读出来的是这一档有多少个。放占比,读出来的是这一档占整体的多大一块。两句话看着接近,实际读出来的分量感差别很大。
还有一种容易被混进来的层次是站点。同一个类目在九个站点上的表现不一样。如果你把九个站点画在同一根横轴上,读出来的差异里有很大一部分是站点差。想看类目之间的差别,站点这一层要先固定住。先固定一层,再看另一层,是这张图能读清楚的前提。
层次分不清楚的时候,有一个很实用的做法。先把这张图要回答的那一个问题写在纸上。然后把横轴和纵轴各自回答的问题写在它下面。两组问题对不上,就说明这张图的层次还没定下来。对得上再去画,画出来的图才有读的地方。
最后一层要说的是颗粒度,同一个层次还有粗细之分。价位段可以切三段,也可以切八段。切三段看的是大方向,切八段能看到局部的起伏。颗粒度选得太粗,起伏会被抹掉。选得太细,图就变成了一条看不出形状的锯齿。
层次还有一个现实的做法,就是先只画一层,画完再决定要不要叠。只画一个站点的类目分布,看清楚之后再决定要不要把第二个站点放进来。直接叠九层,图会密到读不出东西。叠的时候也有讲究,叠的是同一批类目在同一根横轴上。不同批类目叠在一起,横轴本身就对不上了。
层次还有一层关于比较对象的,你要看的是类目之间的差别还是类目内部的差别。类目之间的差别,横轴排类目,读出来的是谁在整体上更厚。类目内部的差别,横轴排这个类目底下的价位段或者子类,读出来的是这个类目内部哪里密。把这两种画在同一张图上,横轴会同时承担两个角色,读的人会迷失方向。所以先定比较对象,再定横轴,这个次序不能倒。
把这两种画在同一张图上,横轴会同时承担两个角色,读的人会迷失方向。他一会儿把柱子当成类目,一会儿当成价位段,读出来的结论会交替变化。这种图看起来内容丰富,实际能用的部分很少。先定比较对象,再定横轴,是拆开这一步的唯一办法。拆开之后各画一张,两张图各自都能读。
先定比较对象,再定横轴,这个次序不能倒。倒过来先定了横轴的排法,再去想这张图要看什么,很容易越看越偏。比较对象定下来之后,横轴上该排什么几乎是自动出来的。这一步省下来的时间,通常会在后面解释图的时候还回去。次序对了,图就少一半的解释成本。
画这一类图最先要解决的是横轴上的东西从哪来。知虾把站点之间、类目之间的差异摆成能直接看的形状,横轴上排谁都能对上号。这一层给的是公开那一块的数,口径统一,所以横着排不会打架。至于图形怎么排更好看,那是画图这一步自己的事。这一层不掺和,也不替你把图画出来。
层次定下来之后,还有一个动作是把这一层的单位说清楚。同一层的类目是按大类算还是按叶子算,这两种的分布形状完全不同。按大类算,柱子会少而粗;按叶子算,柱子会多而细。两种都成立,但混在一起就不成立。所以在画之前先确认这一批数用的是哪一层的类目名。
层次这件事还有一个后果,就是不同层的数不能放在同一个轴上比。大类的商品数天然比它的某个叶子类目多。把它们并排放在一根横轴上,大类那一根会高出一大截。这一截是层级带来的,不是类目之间的差别。要比较,就得先把层级对齐。
定层次还有一个实用的小办法,就是先把这张图的名字写出来。名字里通常要包含站点、层级、时间窗这三样。三样都写出来之后,这张图在看哪一层就清楚了。写不出来的那一样,通常就是还没想清楚的那一样。名字写全,图就少一层被误读的可能。
层次这件事还有一个常见的结果,就是同一批数在不同层次上看起来不一样。按大类看,类目之间差不多;按叶子看,差别可能很大。这种不一样不是数的错,是你站的位置换了。所以看到某个结论的时候,先确认它是站在哪一层说的。层不同,结论就不该直接搬过去用。
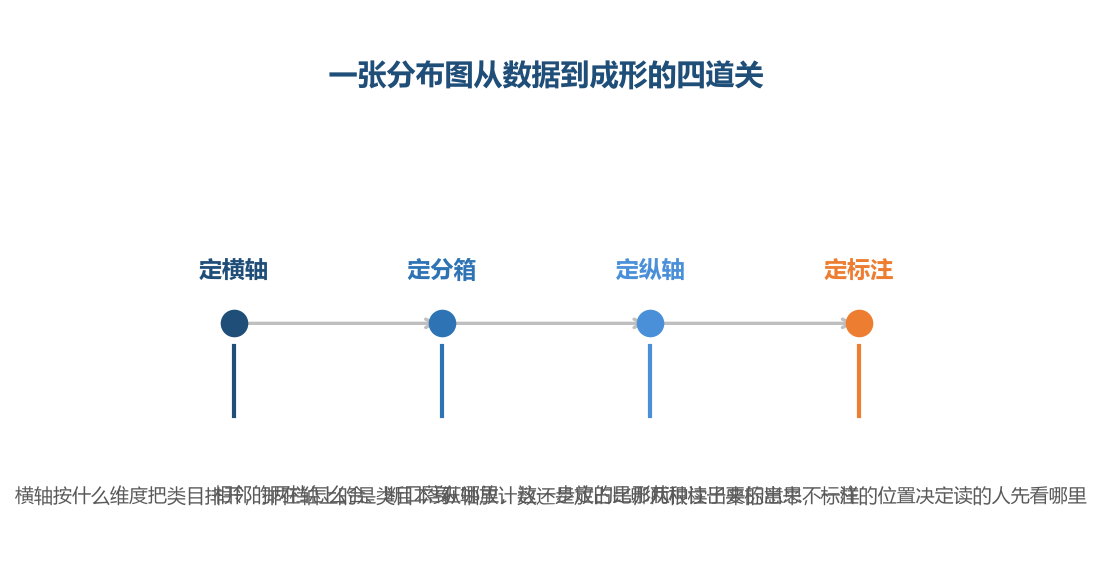
四道关不分先后,是这张图能不能读出东西的四个位置(人造示例)
类目分布图的横轴按什么排
横轴的排法决定这张图能读出什么,这是最先要定的一件事。按类目名排,读出来的是谁排在前面。按数值大小排,读出来的是高低次序。按价位段排,读出来的是分布的形状。三种排法都成立,前提是你要看的东西和排法对应得上。
横轴按什么排,本质上是在回答一个问题,你希望读的人先看到什么。按类目名排,读的人先看到名字,然后再去比高低。按数值大小排,读的人先看到次序,名字反而退到了后面。两种排法没有对错,只是引导的注意力不一样。引导错了,读的人会盯着一个你不关心的位置看半天。
按数值大小排有一个副作用,值得提前知道。排完之后,相邻的两根柱子高低大致是一路递减或者递增的。形状会显得很规整,因为顺序本身就带来了规整。这时候从图上读出来的形状,有一部分是排法造出来的。要看出真实的分布,得按一个中性的次序排一遍再看。
按价位段排也有讲究,价位的分段宽度最好保持一致。宽度不一致,一根宽柱子和一根窄柱子放在一起,视觉上的分量会失真。宽的那一段看起来更厚,实际数量未必更多。统一的段宽能让视觉和数值对应上,减少这类误读。分不了等宽就分段说明,把段宽写清楚。
横轴上如果排的是候选,还要考虑候选的数量。候选只有三个,柱子会很宽,形状看不太出来。候选有二十个,柱子会挤在一起,很多名字要转着写。常见的量是五六个到十几个之间,这个区间里形状和名字都还看得清。超出这个区间,就该考虑换一种排法或者先筛一轮。
横轴排完之后还有一件事,就是轴的顺序要不要跟类别本身的自然顺序走。有些分类本身有阶梯关系,比如规模由小到大。这时候按这个阶梯排,读出来的变化更容易和现实对上。打乱这个阶梯去排,读的人得多绕一步才能理解。能顺着自然顺序排的时候,就顺着排。
横轴的排法还有一个和站点有关的选择。如果要看同一个类目在九个站点上的表现,横轴可以排站点。这样读出来的是这个类目在哪个站点更厚。但它读不出站点之间的类目结构差别,因为横轴上排的一直是同一个类目。想看结构差别,横轴就得换成类目。
横轴的长度也影响读法,柱子多了,每一根都会变窄。变窄之后,视觉上的差异会被放大,矮的那几根看起来更矮。这种放大不是数上的,是视觉上的,读的人分辨不出这个区别。要抵消它,可以在图上留出足够的空白,让每根柱子都有呼吸的位置。柱子的间距保持均匀,是这件事最省力的做法。
变窄之后,视觉上的差异会被放大,矮的那几根看起来更矮。读的人会以为两者差得很远,实际可能只差一点点。这种放大不是数上的,是视觉上的,换一张图读法就变了。要抵消它,可以在图上留出足够的空白。让每根柱子都有呼吸的位置,形状才看得准,这一步比调颜色更管用。
这种放大不是数上的,是视觉上的,读的人分辨不出这个区别。他看到的是差距,看不到差距的来历。要抵消它,可以在图上留出足够的空白,让每根柱子都有呼吸的位置。柱子的间距均匀,视觉上就不会有被刻意突出的那几根。做完这一步再看图,形状读起来会踏实一些。
要抵消它,可以在图上留出足够的空白。空白不是浪费位置,它让相邻的两根柱子不至于贴在一起。让每根柱子都有呼吸的位置,形状才看得准。柱子的间距保持均匀,是这件事最省力的做法。顺序和间距这两样定好了,图上的视觉差就和数上的差大致对得上。
让每根柱子都有呼吸的位置,形状才看得准。挤在一起的柱子会自己造出一段锯齿,那段锯齿不是数据里的东西。柱子的间距保持均匀,是这件事最省力的做法。均匀的间距还有一个好处,换一批数画出来的图,两次的形状可以直接比。可比这件事,比单张图好看与否更重要。
柱子的间距保持均匀,是这件事最省力的做法。间距不一致的时候,宽的那一根会在视觉上占更多分量。读的人会以为它更重要,实际它只是画得宽。间距统一之后,这种错觉就消失了。画图这一步的这些小动作,配合起来决定的是这张图能不能被反复引用。
横轴的排法还有一件事要一起定,就是相邻两档要不要合。有些档位之间的量差得很远,单独放一根柱子会显得很突兀。把相邻的两档合起来,形状会平滑一些,但信息也少了一点。合与不合,取决于你要看的是局部的起伏还是整体的走向。想看整体走向就合,想看具体哪一档厚就别合。
横轴排完之后,还有一个位置要处理,就是轴上的标签。标签太短,读的人对不上号。标签太长,轴上的位置会被挤掉。常见的做法是把标签写短,在图的下面留一行完整的名称。这样轴上不挤,名称也能查得到。
横轴上排的东西还有一个要求,就是它们要能被同一个口径覆盖。同一根轴上的几项,如果口径不一样,柱子之间就没有可比性。这一点在类目这件事上尤其要留意,因为类目名在不同站点的含义不完全一样。跨站点画图的时候,先把类目的对应关系理一遍。理不顺的那几个类目,先不要放进同一张图里。
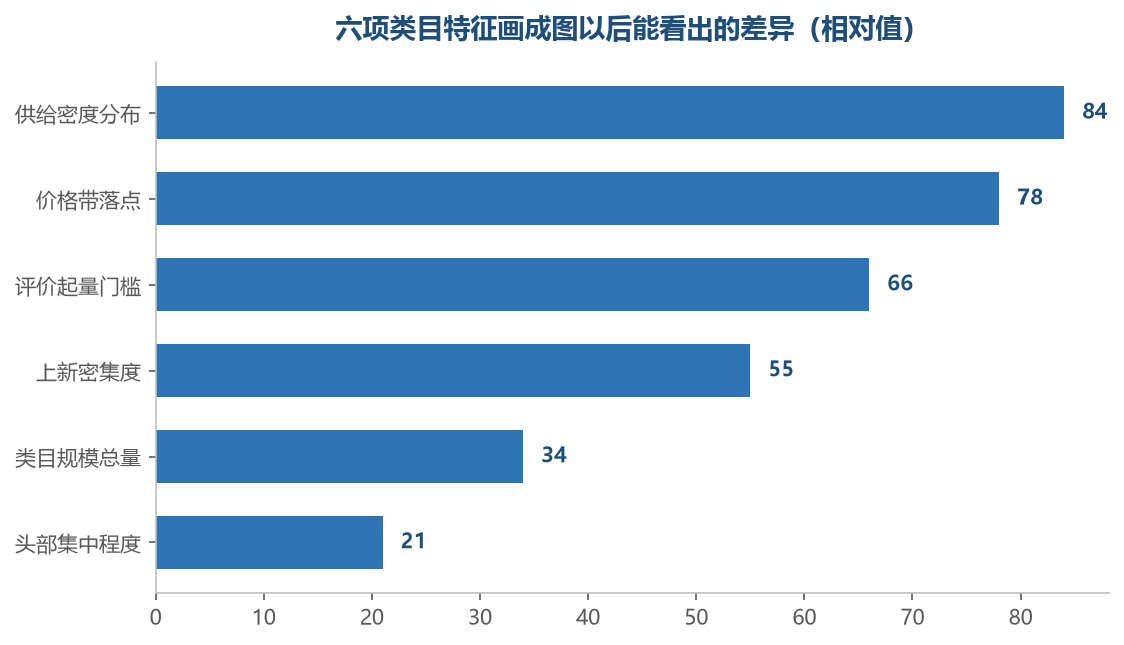
适合画成形状的项排在前面,越往下越该回到一行一列里去读(相对值)
分布图里最怕出现查不到来路的柱子
图上有一根柱子特别高或者特别矮,读的人第一反应是问为什么。这时候如果答不上来这根柱子是怎么来的,整张图的可信度都会受影响。查不到来路通常有两种来源,一种是这一格的数取错了池子。另一种是这一格的数取了另一段时间。两种在图上长得一模一样,都只是一根高一点的柱子。
查不到来路的柱子,问题不在柱子上,在它背后的那个数。一根柱子对应的是某一档上的计数或者占比。这个数是从哪个池子里取出来的,图上通常不写。取全量和取有成交的那一部分,柱子的高低会差很多。所以看见异常高的柱子,第一个动作是回去问池子。
来路还有一个容易被忽略的位置,就是时间窗。同一批类目,按过去一个月取和按过去一年取,分布形状可能完全不同。一个月里可能刚好包含一次大促,那一段会被垫高。一年里包含了大促也包含了淡季,形状会被摊平。两段数都真实,画出来的图却不是一回事。
口径不统一也会造出查不到来路的柱子。同一根横轴上的几根柱子,如果是从不同的口径取的,柱子之间就没法比。图上不会显示这一点,所有柱子长得都一样。要防住它,做法是在画图之前先确认这一批数出自同一套口径。口径检查这一步花的时间很少,省下的解释却很多。
还有一种情况是柱子本身没问题,但标注的位置有问题。标注只标了最高的一根,其余几根的来路就不清楚了。读的人会顺着最高那一根去推测其余的。推测出来的东西未必是图里有的。标注的地方选在哪,决定了读的人会不会自己去补故事。
来路这件事还有一个更根本的做法,就是把口径写在图的下面。写一行小字,写清池子和时间窗。这一行字不会影响图好不好看,但它决定了这张图能不能被反复引用。被引用的时候,别人可以顺手核一遍这一行。核得住,这张图才谈得上可信。
来路这件事还有一个具体的检查办法。把图上异常的柱子和它旁边正常的柱子对着看。两根柱子属于同一批口径的话,旁边那根正常,说明问题出在这一档本身。如果旁边那几根也偏,说明问题出在这一整批数上。一根偏和一片偏,处理的方式不一样。
来路的检查还有一个位置,就是纵轴的单位。纵轴写的是数量,柱子的高就是个数。纵轴写的是占比,柱子的高就是那一块的比例。两种单位混在一张图上,柱子的高低就没有共同含义,同一根柱子在不同人眼里意思可能不一样。单位写在纵轴上,是把这件事挡住最简单的办法。
纵轴写的是数量,柱子的高就是个数。这一档里有几个类目,柱子的高度就反映这个。这种读法直接,但也容易让人把个数当成重要性。个数多的地方往往只是进场的人多。所以看数量轴的图时,心里要同时记着这一层。
纵轴写的是占比,柱子的高就是那一块的比例。这种读法能看出结构,哪一段占了整体的大头。但它看不出实数量,一段占了七成也可能整体很小。两种纵轴各回答一个问题,选哪一种取决于你要问什么。选定了就把单位写在轴上,让读的人自己判断。
两种单位混在一张图上,柱子的高低就没有共同含义。读的人会拿不同单位的柱子直接比高低,比出来的东西没有意义。同一根柱子在不同人眼里意思可能不一样,有人按个数读,有人按占比读。单位写在纵轴上,是把这件事挡住最简单的办法。写一次管整张图,成本很低。
同一根柱子在不同人眼里意思可能不一样,有人按个数读,有人按占比读。这种分歧在讨论的时候很耗时间,因为双方都觉得自己读的没错。根源在于纵轴没有写单位。补上单位之后,分歧通常会自己消失。单位这一行字,省下的往往是会后的一轮来回。
单位写在纵轴上,是把这件事挡住最简单的办法。写在图的副行里也行,只要读的人第一眼能看见。看见之后他就知道柱子的高在说什么。不知道的时候,他会用自己习惯的那一套去补。补出来的东西和图里的数未必是一回事,这一类麻烦大多来自这一行字没写。
来路的检查还可以顺着一件事做,就是哪一项的柱子最需要解释。柱子最异常的那一项,往往就是最该先去核的那一项。核之前先问一句,这一项的取值是让你自己估的还是取来的。估出来的项天然会带一层偏差。取来的项至少可以说清是从哪里取的。
来路的检查还有一个常用的动作,就是把这一项单独画一遍。整张图上柱子的高低混在一起,看不出某一项自己的形状。把这一项单独画出来,异常会变得更明显。变明显之后,再去找它的来路就快得多。分开画一张小图,是这个检查里最省力的一个动作。
来路的检查做完之后,还没结束,还有一步是把结果写下来。哪几根柱子核过、核出来是什么,写在图的下面。写下来之后,下一次看到同样的图,就不用重新核一遍。这一行字也顺便告诉别人,这些柱子是核过的。核过和没核过,读的人在信的程度会不一样。
| 图上位置 | 横轴排什么 | 能读出什么 | 读不出的 | ||||
|---|---|---|---|---|---|---|---|
| 某 | 一 | 段 | 全 | 空 | |||
| 价 | 位 | 段 | |||||
| 这 | 个 | 区 | 间 | 没 | 有 | 候 | 选 |
| 是 | 机 | 会 | 还 | 是 | 不 | 成 | 立 |
类目选择里哪几项适合画成图
能画成形状的项有一个共同点,它的取值是一段分布而不是一个点。一个类目里价格带是怎么分布的,这是一个天然的分布。一个类目里商品数在各档上如何铺开,这也是分布。这两类适合画成形状,因为它们本身就有高低起伏。而像总量这样的项只有一个数,画成图也只是给一个数加了一根柱子。
能画成形状的项,还有一种共同点,它的取值在候选之间是连续的。价格带从低到高,商品数从少到多,这些量能排成一条线。而像某个类目有没有某个规则这类项,只有两个取值。两个取值画成图,只是两根一样高的柱子或者一根柱子。这类项更适合写成一行字,放在图外的说明里。
分布类的项画成图最有价值的地方,是它能显出偏斜。成交主要压在低价段,还是均匀铺开,还是会往高价段拖一条尾巴。这三种形状在现实中的含义很不一样。而如果只看一个平均值,这三种形状会得到同一个数。把分布画出来,就是把平均值盖掉的那一部分重新露出来。
门槛类的项也能画成图,但画的不是分布而是一条线。在一张分布图上画一条竖线,标出某个档位,读的人立刻知道过了这条线意味着什么。线画在哪一档,是判断不是事实。所以画线的时候要说明这条线的来历。来历不明的线,读的人会把它当成一条固定规则。
还有一类项可以画,但画出来的东西容易被误解,就是总量。总量画成一根柱子,几根柱子排在一起就有了高低。读的人会拿总量去比大小,而总量大不代表这个类目好做。总量这一个数单独看意义有限,它更适合和别的项配着看。配着看的时候,用表比用图更清楚。
适合画成图的项还有一个判断方法,问一句形状变了你会不会想知道。形状变了你想知道为什么,这一类项就适合画。形状变了你也做不了什么,这一类项画出来只是多一个需要解释的东西。判断标准就落在这一句上,和好不好看没有关系。这一问花不了几秒钟,却能挡掉图上一半的多余位置。
适合画成图的项还有一个共同点,它们的差异能被眼睛直接分辨。两个候选的差距在一成以内,画成图几乎看不出高低。这种差距在图上就等于没有,读的人会当成平手。差距小的时候,图不是一个合适的表达方式。这时候更应该把数写在格子里,让人去看具体差了多少。
门槛类项画成图还有一个好处,它能让人看出这条线卡掉了多少。线画在某一段上,线左边和线右边的柱子能直接比。一边多一边少,读的人立刻知道这条线是松还是紧。这个信息在格子里也有,但格子里看不出量的对比。所以门槛这一项画图是有意义的,只要把线的来历一起写出来。
线画在某一段上,线左边和线右边的柱子能直接比。左边厚右边薄,说明这道门卡掉了大部分候选。左边薄右边厚,说明这道门过得很松。这个对比不用算,看柱子就能看出来。格子里也能看到这个事实,但只有一行一列地读过去才能形成印象,图中的印象是一眼就成的。
一边多一边少,读的人立刻知道这条线是松还是紧。紧了就该回头看这道门是不是拦得太狠。松了就该看它是不是没起作用。这两种后续动作完全不同,而图上一眼就能分清。所以门槛类项画成图的价值,主要在这一层对比上。
这个信息在格子里也有,但格子里看不出量的对比。格子里读的是每一格的具体值,少了那种两侧厚薄的直观感受。要把这个感受补出来,得自己在脑子里累加。图把这一步替人做了,代价是它说不出具体的数。两者各承担一段,正好接得上。
所以门槛这一项画图是有意义的,只要把线的来历一起写出来。线的来历不写,读的人会把它当成一条固定规则。写成一条固定规则之后,它就会被套用到不该用的地方。把来历写在线的旁边,这一条线就只是一次判断的记录。记录可以讨论,规则只能遵守。
适合画成图的项还有一个特点,它们的含义不需要额外解释。价格带的分布这一形状,看到就明白说的是什么。如果某一项画成图之后还得配上一段说明才知道自己在看什么,那它就不适合画。需要解释的项画成图,读的人会先花时间理解图,再花时间看数。多出来的那一步理解,本身就是成本。
图和表在类目这件事上各管一段
图省掉的精度,得有人补回来。图能告诉你某一档明显厚,但它说不出这一档具体厚到什么程度。也说不清构成这一档的是哪几个类目。这些恰恰是需要往下走的时候必须知道的。所以图给的是一个方向,落到具体动作之前还得回到格子里去。
图和格子的分工,可以用一件事说清楚。图告诉你某个位置很厚,格子告诉你那里具体有几个类目。图告诉你形状偏了,格子告诉你是哪几根柱子把它拉偏的。两句话各自回答了对方回答不了的部分。这也是为什么图上看出问题之后,动作是回格子。
回到格子这一步有一个具体做法,就是把图上异常的档位取出来。取出来之后,把落在这一档里的候选一条条列开。列开之后,通常会发现这一档里其实分了几种情况。有一种是同类目聚在一起,另一种是几个不相关的类目凑巧落在同一档。这两种在图上长得一样,回到格子里才分得开。
精度这一层补回来的方式还有一个,就是给图配一张小表。小表的行数不用多,把图上提到的那几档列出来就够。表放在图的下面,读的人先看图再看表,顺序比较顺。这一张表不需要完整,它的作用是把图上提到的位置交代清楚。交代清楚了,图就不必承担它承担不了的精度。
图上读不出来的还有一部分是构成,也就是某一档里都有谁。一根柱子的高度是两个信息合起来的结果,一个是这档里有几个,另一个是这档里都是谁。图上只显示了前者。要看清后者,得回到一行一列里去读。构成本身没有形状,所以它也画不出来。
还有一个分工常被弄反,就是谁先谁后。先画图再看格子,比先看格子再画图更容易发现整体上的偏向。先看格子的话,人容易陷在具体的某一行里,看不出整体形状。先画一遍图,形成一个整体的印象,再回到格子里去核。这个顺序不是规定,但它能让图真正发挥出它的那一层作用。
图和格子还有一个交接的位置,就是那个介于两者之间的东西。图上留一个标号,格子里也留同一个标号。读的人从图上看到异常,能顺着标号落到具体那一行。标号不必多,把图上提到的几处标上就够了。有了标号,图和格子之间就不是两张纸,而是一件事的两个面。
图和格子还有一个容易混的位置,就是两者都在展示同一批数。图上展示的是形状,格子里展示的是每一格的值。两者说的必须是一回事,只是表达方式不同。图上看着偏,格子里读出来却不偏,那多半是有一边出了问题。这种对不上的时候,先回头核口径,而不是先改图。
图上展示的是形状,格子里展示的是每一格的值。形状是值的排列,值是形状的落点。两者本来是同一件事的两种说法,不该出现互相矛盾。出现了矛盾,说明其中一边取的数不是同一批。核口径这一步比重画一张图更接近问题的答案。
两者展示的是同一批数,所以它们说的必须是一回事。这句话听起来像是不用说的,实际做起来常被忽略。有人用一批数画了图,隔了几天又用另一批数填了格子。两批数的时间窗差了一周,形状自然对不上。同一批数这四个字,是要落实在时间窗上的。
图上看着偏,格子里读出来却不偏,那多半是有一边出了问题。先别急着改图,图可能没错。也先别急着改格子,格子可能也没错。先查的是这两批数是不是同一批。查完再决定改哪一边,比两边一起改要省事得多。
这种对不上的时候,先回头核口径,而不是先改图。图是照着数画出来的,数不对,图改了也是错的。核口径的动作很快,把两边的池子和时间窗对一遍就够。对完之后多半能定位到具体是哪一项不一致。定位到了,改哪一边就不用猜了。
两者对得上,这套材料才算完整。对得上之后,图和格子可以互相引证,读的人信得过。只交其中一样,读的人总要在心里补另一半。补出来的那一半未必和你手上的一致。所以图和格子一起交,是多花一点功夫换来的确定。
图省掉的那部分精度要有人补,回到格子里的时候,格子里的数从哪来也得说清。这几项公开数摆在同一套口径下,在知虾那边一格一格对得下去。它对不上你手上的内部数,这两层本来就不在一个池子里。把两层分开摆,图上说的和格子里说的才不会互相打脸。分得开,两张纸就能一起交。
图和格子还有一个分工上的细节,就是谁先给结论。图先给印象,格子后给依据,这个顺序符合人看东西的习惯。反过来先给依据再给印象,读的人得先看完一大片数才能形成感觉。形成感觉的这一步如果被省掉,后面的讨论会缺一个共同的起点。所以图在前、格子在后的顺序,不只是排版,也是讨论的节奏。
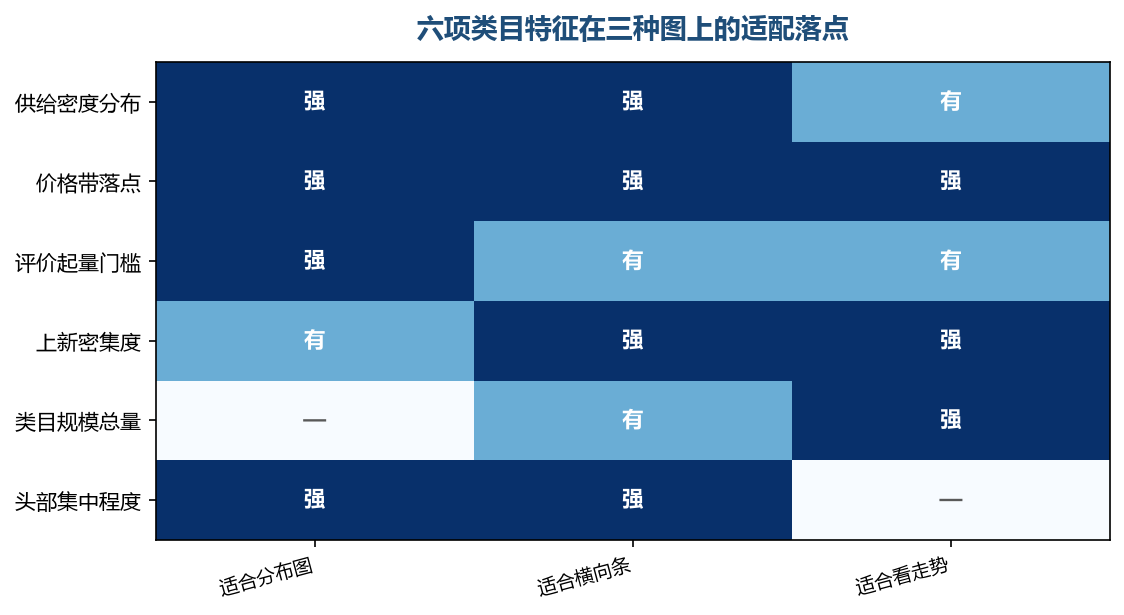
同一批特征在不同图型上落点不同,全零的那一格说明这种画法读不出它
分布图里那块空白往往最值钱
看分布图的时候,人会本能地去看最高的那几根柱子。但真正值得看的往往是某一段完全没有柱子,或者柱子矮得几乎看不见。一段空白意味着这个区间里没有候选,或者候选少得可以忽略。它可能是一个还没人占的位置。也可能是一个天然不成立的区间,两种解释在图上分不出来。
空白的读法需要先分两种情况,一种是完全没有柱子。这一段在取数的时候一根都没有,说明这个区间里没有候选。另一种是柱子很矮,几乎贴在地上。两种在图上看起来接近,实际含义差得很远。一种是零,一种是很小但存在。
空白落在哪一段,也很影响它的含义。空白落在分布的两端,说明这个区间被排除在外。可能是不成立,也可能是没人做。空白落在分布的中间,通常更值得多看一眼。中段塌陷往往意味着这个位置被某种成本或者规则挡住了。
空白还有一种来源是取数方式造成的,这一点要特别留意。如果这一批数是按某种条件筛过之后才取出来的,那空白可能是筛出来的。筛选条件没有写在图上,读的人就会把它当成一个自然现象。要防住它,做法是把筛选条件写在图的下面。写清楚了,读的人才知道这块空白是真的还是造出来的。
看到空白之后,接下来的动作不是立刻下判断。先把这一段的相邻两段看一看。如果两侧都很厚,中间空着,那这个位置特殊。如果两侧本来也薄,那它只是整体的尾部。先看邻居,再看空白本身,这样读出来的东西更稳。
空白值不值得追,还有一个很实际的标准。追进去要花多少功夫,追出来之后能改变什么。这一段的空白如果找不到任何可以拿来做的货,那追进去也没有后续。如果手上正好有能对上这一段的货,那它就值得单独看一眼。空白是提示,它把注意力引到一个位置上,剩下的还得靠手上的条件去判断。
空白还有一种读法,就是看它是不是对称出现的。中段塌陷在几个站点上都出现,说明这个位置普遍被挡住。只在一个站点上出现,说明这个站点的特殊情况。两种情况下的后续动作差得很远。画图的时候顺手把站点分开画一遍,就能看出这个区别。
空白还有一种处理方式是把它标出来。在某一段上画一个记号,注明这一段没有候选。标明之后,读的人就不会以为是自己没看见。不标的话,那块空白很容易被当成排版留白。标出来的空白才是一个能拿来讨论的位置。
在某一段上画一个记号,注明这一段没有候选。记号不用复杂,一个小小的标注就够。关键是它要出现在图本身上,而不是写在旁边的说明里。写在说明里容易被跳过去。写在图上,读的人绕不开它,也就不会漏掉这一处。
标明之后,读的人就不会以为是自己没看见。他会把这个空白当成一个信息来处理。是问为什么空,还是直接过掉,这个选择交给他。不标的话,他连选择的机会都没有。标与不标,差的是一条能被讨论的线索。
不标的话,那块空白很容易被当成排版留白。读的人会以为那一块只是没画。他可能整段跳过去,也可能自己脑补一点东西填上。脑补出来的内容不会和事实一致。所以标上记号,其实是在替读的人省掉一次脑补。
标出来的空白才是一个能拿来讨论的位置。讨论得有对象,空白标出来了才有对象。针对这个位置可以问这一段为什么空,是不是有人做过。这些问题在图上是问不出来的。但图把提问的位置给了出来。这一层作用在没标注的图里就失去了。
这一步花的功夫很少,效果却很明显。加一个记号不会影响图的观感,也不会拖慢进度。但它把一处需要追问的位置固定了下来。固定下来之后,这张图就不只是一张展示图。它变成了一张能引出问题的图,这才是图该起的作用。
空白这件事还有一个视角,就是它在不同站点上的出现位置不一样。同一个类目在一处的空白,到另一处可能就有柱子。这种差别往往比柱子本身的高低更值得看。因为它直接指向的是一个位置在不同地方成不成立。画图的时候把几个站点的图并排放,这一类差别就能看出来。
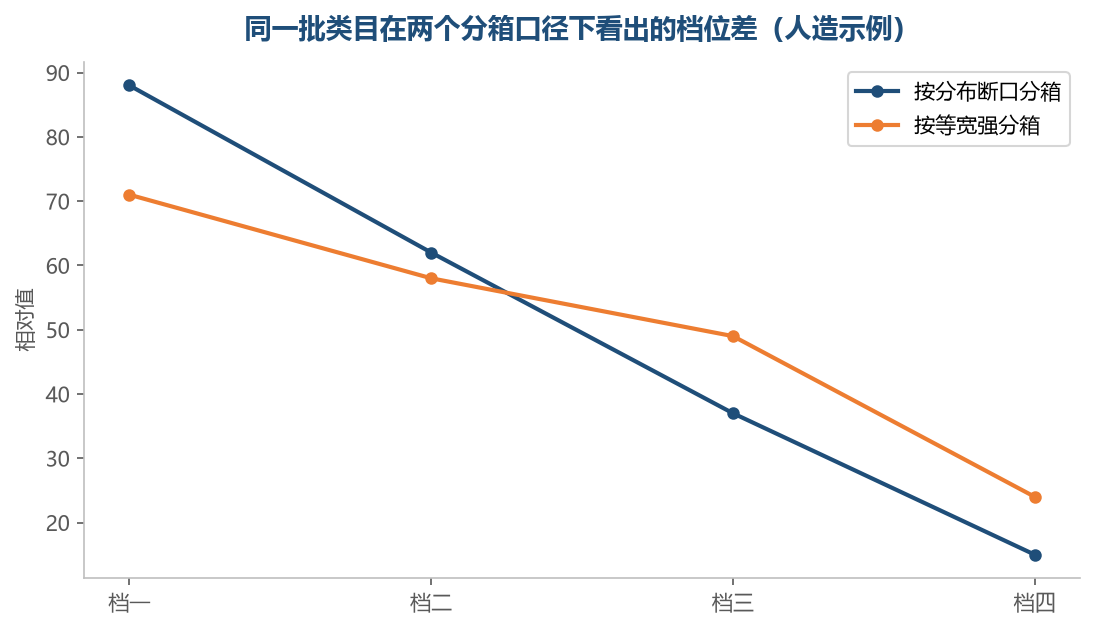
分箱的口径一换,同一批数的形状就会变化,读出来的结论也跟着变(人造示例)
虾皮类目选择画图时最常见的三种误读
第一种误读是把横轴当成时间轴来读。横轴排的是类目或者价位段,它们之间没有先后关系。但人在看图的时候习惯从左往右读成一种推进。于是相邻的两根柱子会被当成前后两个阶段来比较。这种误读很常见,因为图本身不会提醒你横轴上排的是什么。
第二种误读是把不同类目的柱子直接比高低,而忽略它们池子不同。两个类目的规模本身差了很远,柱子高低主要反映的是规模差。读的人会把这个差当成这两个类目在某项特征上的差别。实际上两者在这一项上的特征可能很接近。要防住它,用的量要换成占比而不是计数。
第三种误读是只看最高那一根,把它当成整个分布的结论。最高那一根说明这一段最厚,不说明这一段值得做。厚可能是因为进场的人多,也可能是因为门槛低。这两种解释的后续动作完全相反。只看一根柱子,就得不出接下来的动作。
还有一种误读是把纵轴上的高度当成重要性。柱子高说明这个位置上的数量多,不说明这个类目重要。数量多的地方往往竞争也密,这一点图上不会显示。把高度当重要性,会让人往最厚的地方挤。所以图上的高度只能当线索,不能当依据。
误读还有一个共同的来源,图上没有写标题的副行。标题写了这张图讲类目分布,但没有写是哪个站点、哪段时间、哪个层级。这三样缺一个,读的人就会用自己默认的那一套去补。补出来的东西和图里的数未必是一回事。副行写全,是把这一类误读挡住最省力的办法。
把这三种误读放在一起看,会发现它们都指向同一件事。图这个形状天生不擅长说明自己的前提。它把形状画出来了,但形状背后站着什么,要靠图外的字来说。所以一张能用的图,通常是图加一行说明。少了那一行,图越漂亮越容易被读歪。
误读还有一个来源是把分布的高度当成趋势。分布图画的是同一时点上不同位置的厚薄。它不包含时间这一个维度。读的人有时会顺着柱子的高低读出一条上升或者下降的线。那条线是读出来的,不是图里本来就有的。
误读还有一种是把图上的空白当成数据缺失。有些空白是真的没有候选,有些是取数的时候漏了。两种在图上一样,在后续动作上完全不同。所以要养成一个习惯,看到空白先确认它是哪一类。确认的方式也很简单,回格子里把那一档的数找出来看一眼。
有些空白是真的没有候选,有些是取数的时候漏了。真的没有候选,说明这个区间在现实中就是这么薄或者干脆是空的。漏了的话,说明这一批数不完整,图上其余的部分也要重新看一遍。两种情况的处理方向几乎是相反的。分不清的时候,很容易往错的那一边走。
两种在图上一样,在后续动作上完全不同。一种是把这一段当成一个可以去看看的位置。另一种是把整批数退回去重取。走错了方向,花掉的时间就白花了。所以看到空白的第一件事不是下结论,是分类。分类这一步都不用离开这张图就能做完。
所以要养成一个习惯,看到空白先确认它是哪一类。确认的方式也很简单,回格子里把那一档的数找出来看一眼。找得到就是漏了,找不到就是真的空。这一步的动作很小,但它决定了你会不会去追一个并不存在的位置。养成这个习惯之后,看图的速度不会变慢,判断的准头会变好。
确认的方式也很简单,回格子里把那一档的数找出来看一眼。格子里如果这一档有数而图上没有柱子,那就是画的时候漏了或者分箱切错了。格子里如果这一档也是空的,那就是真的没有候选。这个来回只要几秒钟,却能替掉后面一长串的追问。所以图和格子放在一起,本身就是一种互相校验。
找得到就是漏了,找不到就是真的空。漏了要回头改分箱或者补数,真的空可以进入下一步讨论。两种后续动作的差别很大,而判断的依据只是回头看一眼。这一眼的价值,往往比在图上反复端详要高。看图这件事的很多效率,就藏在这样的一个小动作里。
这一步的动作很小,但它决定了你会不会去追一个并不存在的位置。追一个不存在的位置,会花掉后面一连串的时间。而判断它是否存在,只需要回格子里看一眼。所以看图的时候,图上读出来的每一个异常,都值得配一次格子里的核对。核对完了再决定往哪走,这个顺序不容易出错。
误读还有一种来源是图上只画了通过的候选,被挡掉的没有画。读的人看到的是一段完整连续的分布。实际上这一段是被筛过之后剩下的。筛掉的排除了什么,图上完全看不出来。要防住它,做法是把筛掉的那一批也画一遍,或者至少标出筛在哪一道。
误读还有一种是只看形状不看轴上的单位。两根柱子看着差不多高,单位不一样就没法比。一种是以个为单位,一种是以百个为单位。这种情况在多张图并排看的时候特别容易发生。所以几张图放在一起之前,先把单位对一遍。